Robots.txt is een klein tekstbestand in de hoofdmap van je website dat zoekmachines vertelt welke delen van je site ze wel en niet mogen bezoeken. Je vindt het op een vast adres: jouwwebsite.nl/robots.txt. Het regelt dus het crawlen, en niet of een pagina in Google komt. Dat verschil is de bron van de meeste fouten. In deze blog lees je hoe het bestand werkt, hoe je het maakt en controleert, en wat je beter niet kunt doen.
Dit lees je in deze blog:
- Wat is robots.txt?
- Hoe werkt robots.txt?
- Heb je een robots.txt nodig?
- Voorbeeld van een goed robots.txt-bestand
- Robots.txt maken in 5 stappen
- Je robots.txt controleren en testen
- Robots.txt of noindex: wat gebruik je wanneer?
- Robots.txt en AI-crawlers
- Veelgemaakte fouten
- Veelgestelde vragen
Wat is robots.txt?
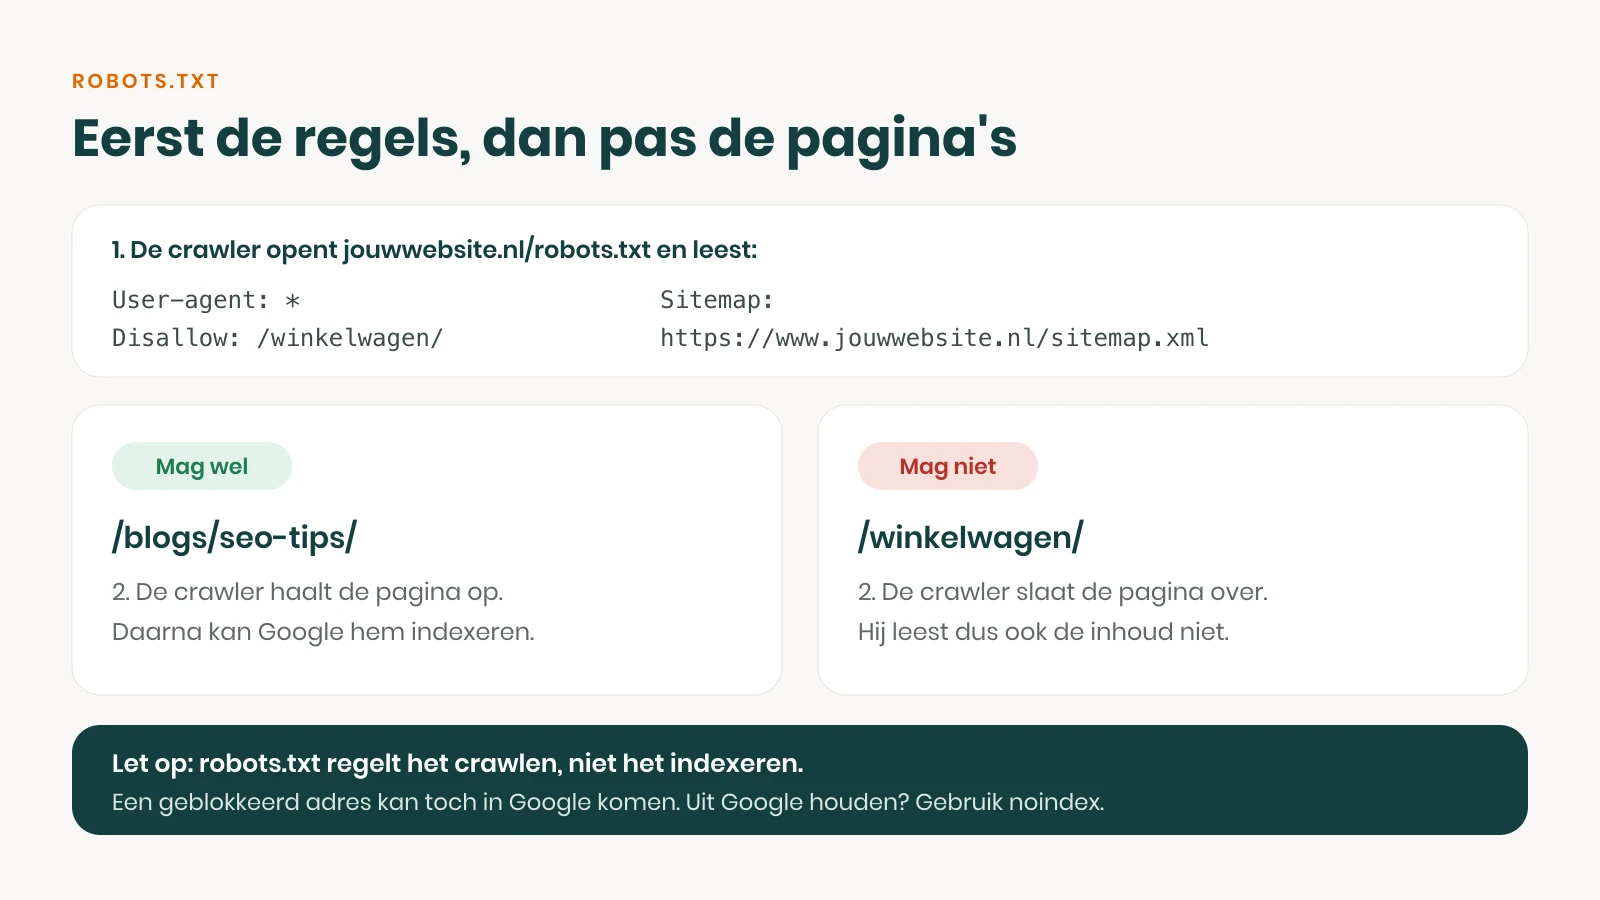
Robots.txt is een openbaar bestand met regels voor crawlers: de programma's waarmee zoekmachines en andere diensten het internet doorlopen. Googlebot en Bingbot zijn daar de bekendste voorbeelden van. Voordat zo'n crawler pagina's van je website ophaalt, kijkt hij eerst of er een robots.txt is en welke regels daarin staan.
Je kunt het zien als een bordje bij de ingang: hier mag je komen en hier hoef je niet te komen. Het is een afspraak, geen slot op de deur. Volgens de documentatie van Google houden Googlebot en andere nette crawlers zich aan de regels, maar kan een crawler ze ook negeren. Voor vertrouwelijke gegevens is robots.txt dus niet geschikt. Daarvoor gebruik je een wachtwoord.
Omdat iedereen het bestand kan openen, laat je er ook meteen de mappen in zien die je noemt. Zet er dus geen adressen in die je geheim wilt houden. Wil je er een bekijken? Typ achter een willekeurig webadres /robots.txt.
Hoe werkt robots.txt?
Het bestand bestaat uit groepjes regels. Elk groepje begint met de crawler waarvoor de regels gelden, gevolgd door wat die crawler wel of niet mag. Je hebt maar een paar woorden nodig:
- User-agent: voor welke crawler de regels gelden. Een sterretje (*) betekent: voor alle crawlers.
- Disallow: het pad dat de crawler niet mag ophalen.
- Allow: een uitzondering binnen een geblokkeerde map.
- Sitemap: het volledige adres van je XML-sitemap, zodat crawlers die makkelijk vinden.
Dit zijn de vaste plekken en spelregels:
- Het bestand moet precies robots.txt heten en in de hoofdmap staan. In een submap wordt het niet gelezen.
- Elk subdomein heeft een eigen bestand. De regels van www.jouwwebsite.nl gelden niet voor shop.jouwwebsite.nl.
- Paden zijn hoofdlettergevoelig: /Blog/ is iets anders dan /blog/.
- Staat er geen bestand, dan mag een crawler in principe alles ophalen.
Wat crawlen precies is en waarom het ertoe doet, lees je in de blog over crawlen en crawlbudget.
Heb je een robots.txt nodig?
Voor een kleine website is het niet verplicht. Heb je niets te blokkeren, dan werkt je site ook zonder bestand. Toch is een eenvoudig bestand handig, omdat je er de plek van je sitemap in kunt zetten.
Het wordt nuttiger als je website veel pagina's heeft die zoekmachines niet hoeven te bezoeken. Denk aan:
- interne zoekresultaten op je website;
- de winkelwagen en de afrekenpagina van een webshop;
- filterpagina's die eindeloos veel adressen opleveren;
- een inlogomgeving of beheergedeelte.
Gebruik je WordPress, Shopify of Wix? Dan maakt je systeem vaak al zelf een robots.txt aan, en soms kun je het bestand niet rechtstreeks aanpassen. Kijk dan bij de zoekinstellingen van je systeem of in je SEO-plug-in.
Voorbeeld van een goed robots.txt-bestand
Dit is een eenvoudig voorbeeld voor een webshop:
User-agent: *
Disallow: /winkelwagen/
Disallow: /afrekenen/
Disallow: /zoeken/
Allow: /zoeken/hulp/

Sitemap: https://www.jouwwebsite.nl/sitemap.xml
Alle crawlers mogen de hele website bezoeken, behalve de winkelwagen, de afrekenpagina en de zoekresultaten. Eén pagina binnen de map met zoekresultaten mag wel. Onderaan staat de sitemap.
Wil je zeker weten dat alles mag? Dan is dit voldoende:
User-agent: *
Disallow:

Sitemap: https://www.jouwwebsite.nl/sitemap.xml
Let op het verschil met de gevaarlijkste regel die er bestaat. Met Disallow: / blokkeer je namelijk je hele website. Eén schuine streep maakt hier het verschil.
Robots.txt maken in 5 stappen
- Bekijk wat er al staat. Ga naar jouwwebsite.nl/robots.txt. Staat daar al iets, begin dan met dat bestand en gooi het niet zomaar weg.
- Bepaal wat crawlers niet hoeven te zien. Maak een korte lijst. Twijfel je over een pagina, laat hem dan toegankelijk.
- Schrijf het bestand. Gebruik een eenvoudige teksteditor, zoals Kladblok of Teksteditor, en sla het op als platte tekst met de naam robots.txt. Een programma als Word voegt opmaak toe die er niet in hoort.
- Zet het in de hoofdmap. Upload het via je hostingpaneel of FTP, of gebruik de editor in je SEO-plug-in. Het bestand moet te openen zijn op jouwwebsite.nl/robots.txt.
- Controleer het. Open het adres in je browser en kijk daarna in Search Console of Google het kan lezen.
Je robots.txt controleren en testen
De losse robots.txt-tester van Google bestaat niet meer. In de plaats daarvan kun je twee onderdelen van Google Search Console gebruiken:
- Het robots.txt-rapport. Je vindt het via Instellingen. Daar zie je welke bestanden Google heeft gevonden, wanneer ze voor het laatst zijn opgehaald en of er fouten in staan. Google beschrijft dit in de Search Console Help.
- De URL-inspectie. Plak het adres van een pagina in de zoekbalk bovenin. Je ziet dan of de pagina door robots.txt wordt geblokkeerd.
Pas je het bestand aan, dan ziet Google dat niet meteen. Google bewaart de inhoud meestal maximaal een dag, en via het rapport kun je om een nieuwe controle vragen.
Melding "Geblokkeerd door robots.txt" oplossen
Krijg je deze melding in Search Console? Inspecteer dan eerst de pagina en kijk of hij echt in Google moet staan. Zo ja, zoek de Disallow-regel die het pad blokkeert en haal die weg of maak hem specifieker. Daarna vraag je via de URL-inspectie opnieuw om indexering. Hoe dat werkt, lees je in de blog over Google indexering. Moet de pagina niet in Google staan, dan hoef je niets te doen.
Robots.txt of noindex: wat gebruik je wanneer?
Dit is het belangrijkste misverstand. Robots.txt bepaalt of een crawler een pagina mag ophalen. Een noindex-tag bepaalt of een pagina in de zoekresultaten mag staan. Volgens Google kan een geblokkeerde pagina toch in de zoekresultaten verschijnen, bijvoorbeeld als andere websites ernaar linken. Je ziet dan wel het adres, maar geen beschrijving.
| Je wilt | Gebruik |
|---|---|
| Crawlers weghouden bij onbelangrijke pagina's | Robots.txt |
| Een pagina uit de zoekresultaten houden | Noindex |
| Een pagina echt afschermen | Wachtwoord |
| Bij dubbele pagina's de juiste versie aanwijzen | Canonical tag |
Combineer robots.txt en noindex niet op dezelfde pagina. Als een crawler de pagina niet mag ophalen, ziet hij de noindex-tag ook niet. Wil je een pagina uit Google halen, laat hem dan toegankelijk tot hij uit de resultaten is verdwenen.
Robots.txt en AI-crawlers
Ook AI-diensten gebruiken crawlers, en veel daarvan kun je via robots.txt aanspreken. OpenAI noemt bijvoorbeeld GPTBot en OAI-SearchBot, en Google heeft Google-Extended voor het gebruik van content voor zijn AI-modellen. Wil je dat GPTBot je site niet ophaalt, dan schrijf je:
User-agent: GPTBot
Disallow: /
Bedenk wel wat je wilt bereiken. Blokkeer je AI-crawlers, dan word je mogelijk ook minder vaak genoemd in AI-antwoorden. Wil je daar juist in opduiken, lees dan de blog over AI SEO. Een ander bestand dat daarbij vaak wordt genoemd is llms.txt; dat heeft een ander doel en vervangt robots.txt niet.
Veelgemaakte fouten
- De hele website blokkeren. Dit gebeurt vaak als een testomgeving live gaat en
Disallow: /blijft staan. Controleer dit na elke nieuwe website of verhuizing. - Robots.txt gebruiken om pagina's uit Google te halen. Daarvoor is noindex bedoeld.
- CSS- en JavaScript-bestanden blokkeren. Google heeft ze nodig om je pagina goed te begrijpen.
- Geheime adressen noemen. Het bestand is openbaar en laat dus zien waar die adressen staan.
- Een verkeerde plek of naam. Robots.TXT of een bestand in een submap werkt niet zoals je verwacht.
- Het bestand nooit meer bekijken. Neem het mee in je technische SEO-controle.
Zelf je techniek en vindbaarheid op orde krijgen
Robots.txt is één onderdeel van de technische basis van je website. Wil je stap voor stap leren hoe techniek, inhoud en autoriteit samen bepalen of je gevonden wordt? Dat leer je in de SEO basistraining.
Veelgestelde vragen
Om crawlers te vertellen welke delen van je website ze wel en niet mogen ophalen. Zo voorkom je dat ze tijd besteden aan onbelangrijke pagina's, zoals zoekresultaten of een winkelwagen.
Bij nette crawlers wel: Googlebot en Bingbot houden zich eraan. Het is alleen geen beveiliging. Kwaadwillende bots kunnen de regels negeren, en een geblokkeerd adres kan toch in Google verschijnen als andere sites ernaar linken.
Het bestand zelf is een technische afspraak en dwingt niets af. Of negeren juridisch gevolgen heeft, hangt af van de situatie en het land. Dat is een vraag voor een jurist. Wil je iets echt afschermen, zet er dan een wachtwoord op.
Open een eenvoudige teksteditor, schrijf de regels en sla het bestand op als robots.txt in platte tekst. Upload het daarna naar de hoofdmap van je website, of gebruik de editor van je SEO-plug-in als je WordPress hebt.
Controleer of de pagina in Google moet staan. Zo ja, pas de Disallow-regel aan die de pagina blokkeert, controleer het resultaat in Search Console en vraag opnieuw om indexering. Zo niet, dan hoef je niets te doen.
Google leest volgens zijn documentatie maximaal 500 KiB. Een normaal bestand blijft daar ruim onder: de meeste websites hebben aan een paar regels genoeg.
Geschreven door
Celine · Goldcompass
Online marketeer en trainer. Werkt dagelijks aan SEO, Google Ads en content voor ondernemers, en vertaalt dat naar praktische trainingen zonder jargon.
Zelf aan de slag met seo?
In de training SEO basistraining leer je het stap voor stap, direct toepasbaar op je eigen bedrijf.