Crawlen is het proces waarbij een zoekmachine zoals Google met een programma webpagina’s opvraagt en leest. Dat programma heet een crawler of spider en bij Google heet hij Googlebot. De crawler volgt links van pagina naar pagina en haalt zo nieuwe en gewijzigde pagina’s op. Pas als Google een pagina heeft gecrawld kan hij die indexeren en tonen in de zoekresultaten.
In deze blog lees je wat crawlen precies is, hoe het verschilt van indexeren en ranken en wat crawlbudget (in het Engels crawl budget) betekent. Je leest ook eerlijk of jij je daar zorgen over hoeft te maken en hoe je in Google Search Console ziet hoe Googlebot jouw website bezoekt.
Dit lees je in deze blog:
- Wat is crawlen?
- Wat is het verschil tussen crawlen, indexeren en ranken?
- Hoe werkt crawlen stap voor stap?
- Hoe vaak crawlt Google je website?
- Wat is crawlbudget?
- Moet je je zorgen maken over je crawlbudget?
- Waardoor gaat crawlbudget verloren?
- 6 manieren om je crawlbudget beter te benutten
- Hoe controleer je hoe Google je site crawlt?
- Veelgestelde vragen
Wat is crawlen?
Crawlen betekent letterlijk kruipen. Een crawler is een programma dat automatisch webpagina’s opvraagt, net zoals jouw browser dat doet, alleen zit er geen mens achter. Hij leest de code van de pagina, geeft de inhoud door aan de zoekmachine en noteert alle links die hij tegenkomt. Die links komen op een lijst met adressen die hij later bezoekt. Zo kruipt hij als een spin over het web en daar komt de andere naam vandaan: spider.
Je kunt het vergelijken met een bibliothecaris die nieuwe boeken binnenkrijgt. Hij bekijkt de titel, leest de inhoudsopgave en bladert erdoor om te bepalen waar het boek over gaat. Pas daarna krijgt het een plek in de kast. Crawlen is dat binnenhalen en doorbladeren. De plek in de kast is de index.
Wat is Googlebot?
Googlebot is de naam van de crawler van Google Zoeken. Er zijn twee varianten: Googlebot Smartphone en Googlebot Desktop. De meeste websites worden vooral door de smartphonevariant bezocht, omdat Google de mobiele versie van een pagina gebruikt om hem te indexeren. Andere zoekmachines hebben hun eigen crawler, zoals Bingbot van Bing.
Je herkent Googlebot in de logbestanden van je server aan de user-agent. Let op dat andere bots zich soms als Googlebot voordoen. In de documentatie over Googlebot legt Google uit hoe je controleert of een bezoek echt van Google komt.
Wat is het verschil tussen crawlen, indexeren en ranken?
Deze drie termen worden vaak door elkaar gebruikt, maar het zijn drie aparte stappen. Elke stap bouwt voort op de vorige.
| Stap | Wat gebeurt er? | Waar heb jij invloed op? |
|---|---|---|
| Crawlen | Googlebot vraagt je pagina op en leest de code | De pagina is bereikbaar via links of je sitemap en niet geblokkeerd in robots.txt |
| Indexeren | Google analyseert de inhoud en slaat de pagina op in de index | Unieke en nuttige inhoud, geen noindex en een kloppende canonical tag |
| Ranken | Bij een zoekopdracht bepaalt Google welke geïndexeerde pagina’s het best passen en in welke volgorde | Content die de zoekvraag beantwoordt, goede interne links en vertrouwen in je website |
Een gecrawlde pagina is dus niet automatisch geïndexeerd. Google kan een pagina bezoeken en daarna besluiten hem niet op te nemen, bijvoorbeeld omdat hij te veel lijkt op een andere pagina. In het rapport Pagina-indexering van Search Console zie je dat terug als een pagina die wel gecrawld is maar momenteel niet geïndexeerd. Hoe je dat oplost lees je in de blog 13 tips voor Google indexering.
Hoe werkt crawlen stap voor stap?
- Ontdekken. Google moet eerst weten dat een URL bestaat. Dat gebeurt via links op andere websites, via interne links op je eigen site, via je XML-sitemap of doordat je de URL zelf aanbiedt met de URL-inspectietool in Search Console.
- Robots.txt controleren. Voordat Googlebot een pagina opvraagt kijkt hij in het bestand robots.txt of hij die pagina mag bezoeken. Is het pad geblokkeerd, dan slaat hij de pagina over.
- Ophalen. Googlebot vraagt de pagina op bij je server en leest de HTML: de titel, koppen, tekst, links, de meta robots-tag en de canonical tag.
- Renderen. Google voert het JavaScript van de pagina uit met een recente versie van Chrome, zodat hij ziet wat een bezoeker ook ziet. Inhoud die alleen via JavaScript verschijnt wordt dus pas in deze stap zichtbaar.
- Doorgeven aan indexering. De opgehaalde inhoud gaat naar de indexering, waar Google beslist of de pagina in de index komt.
Een pagina waar geen enkele link naartoe gaat noemen we een weespagina. Google vindt zo’n pagina alleen via je sitemap of een andere bron en ziet hem vaak als minder belangrijk. Daarom zijn interne links een vast onderdeel van technische SEO.
Hoe vaak crawlt Google je website?
Daar is geen vast schema voor. Google bepaalt per website en per pagina hoe vaak hij terugkomt. Een site die dagelijks nieuwe artikelen publiceert en veel bezoekers trekt wordt vaker bezocht dan een bedrijfssite waarvan de teksten jaren hetzelfde blijven. Ook binnen één website verschilt het: je homepage wordt meestal vaker opgevraagd dan een oude blog diep in je archief.
Je kunt Google niet dwingen om vaker te komen. Je kunt wel helpen door nieuwe pagina’s in je sitemap te zetten en ernaar te linken vanaf pagina’s die al vaak bezocht worden. Voor één losse pagina kun je in Search Console een indexeringsverzoek doen. Google geeft zelf aan dat crawlen daarna een paar dagen tot een paar weken kan duren.
Wat is crawlbudget?
Googlebot heeft niet onbeperkt tijd en capaciteit. Daarom bestaat het begrip crawlbudget, in het Engels crawl budget. Google omschrijft het als de verzameling URL’s die Google op jouw website kan en wil crawlen. Dat budget bestaat uit twee delen.
Crawlcapaciteit (crawl capacity limit)
Dit is hoeveel Google tegelijk bij je server kan opvragen zonder die te overbelasten. Reageert je server snel en stabiel, dan gaat de limiet omhoog. Wordt je site trager of geeft hij serverfouten (5xx), dan crawlt Google minder. De limiet geldt voor alle crawlers van Google samen.
Crawlbehoefte (crawl demand)
Dit is hoeveel Google van je site wil crawlen. Google noemt drie factoren:
- Omvang zoals Google die ziet: veel dubbele of onbelangrijke URL’s kosten crawltijd die niet naar je echte pagina’s gaat.
- Populariteit: URL’s die populair zijn op internet worden vaker gecrawld.
- Actualiteit: Google wil pagina’s opnieuw bezoeken om wijzigingen op te merken.
Ook als je server veel aankan crawlt Google minder wanneer de behoefte laag is. Alles over deze twee delen lees je in de gids over crawlbudget op Google Search Central.
Moet je je zorgen maken over je crawlbudget?
Voor de meeste websites is het antwoord nee. Google schrijft in de gids over crawlbudget dat die bedoeld is voor grote websites. Als ruwe schatting noemt Google sites met meer dan een miljoen unieke pagina’s waarvan de inhoud ongeveer wekelijks verandert en sites met meer dan tienduizend unieke pagina’s waarvan de inhoud dagelijks verandert. Ook sites waarvan een groot deel van de URL’s in Search Console als ontdekt maar niet geïndexeerd staat horen erbij.
Heb je een kleinere site, dan is volgens Google een actuele sitemap en regelmatig een blik op het rapport Pagina-indexering genoeg. Dat geldt voor de meeste bedrijfssites, blogs en kleine webshops. Wordt bij zo’n site een pagina niet gecrawld of niet geïndexeerd, dan ligt de oorzaak bijna altijd ergens anders: de pagina is niet goed bereikbaar, staat per ongeluk op noindex of voegt te weinig toe ten opzichte van andere pagina’s.
De tips hieronder zijn daarom vooral belangrijk voor grote sites en webshops met veel filters. Voor kleinere sites zijn ze nog steeds goede technische basis, alleen moet je er geen wonderen van verwachten voor je crawlbudget.
Waardoor gaat crawlbudget verloren?
Crawlbudget gaat verloren als Googlebot tijd besteedt aan URL’s die niets toevoegen. De bekendste oorzaken:
- Parameter-URL’s: filters en sorteeropties in een webshop (zoals ?kleur=rood of ?sortering=prijs) en campagneparameters maken van één pagina tientallen varianten.
- Dubbele URL’s: dezelfde pagina is bereikbaar met en zonder www, via http en https of met en zonder slash aan het eind.
- Soft 404’s: pagina’s die laten zien dat iets niet bestaat maar toch statuscode 200 teruggeven. Google blijft die opnieuw crawlen.
- Lange redirectketens: elke tussenstap kost een extra verzoek.
- Eindeloze reeksen: kalenders waarin je oneindig door kunt klikken of interne zoekresultaten die voor elke zoekterm een nieuwe URL maken.
- Een trage of instabiele server: dan verlaagt Google de crawlcapaciteit en worden er minder pagina’s opgehaald.
6 manieren om je crawlbudget beter te benutten
Het doel is dat Googlebot zijn tijd besteedt aan de pagina’s die je in Google wilt laten zien. Dit zijn de stappen die Google zelf aanraadt.
1. Houd je sitemap actueel
Zet in je XML-sitemap alleen de pagina’s die je geïndexeerd wilt hebben en geef met lastmod aan wanneer een pagina inhoudelijk is gewijzigd. Dien de sitemap in via Search Console onder Sitemaps. Een stappenplan vind je in de blog sitemap maken.
2. Link intern naar je belangrijke pagina’s
Googlebot ontdekt pagina’s door links te volgen. Zorg dat je belangrijkste pagina’s vanaf je homepage of hoofdmenu met een paar klikken bereikbaar zijn en link ernaar vanuit blogs en categoriepagina’s. Gebruik een ankertekst die beschrijft waar de link naartoe gaat in plaats van “klik hier”.
3. Blokkeer onbelangrijke URL’s met robots.txt
Met robots.txt vertel je crawlers welke paden ze moeten overslaan, zoals interne zoekresultaten of filtercombinaties. Een eenvoudig voorbeeld:
User-agent: *
Disallow: /wp-admin/
Disallow: /zoekresultaten/
Sitemap: https://www.jouwwebsite.nl/sitemap.xml
Let op het verschil met noindex. Een noindex-tag houdt een pagina uit de index, maar Google moet de pagina wel crawlen om die tag te zien. Noindex bespaart dus geen crawltijd. Robots.txt voorkomt het crawlen, maar een geblokkeerde URL kan nog steeds in Google verschijnen als andere pagina’s ernaar linken. Gebruik ze niet samen op dezelfde pagina, want dan ziet Google de noindex nooit.
4. Ruim foutpagina’s en redirectketens op
Geef voor pagina’s die definitief weg zijn een 404 of 410 terug. Dat is voor Google een duidelijk signaal om die URL niet meer te crawlen. Los soft 404’s op en verwijs oude URL’s met één 301-redirect direct naar de nieuwe pagina in plaats van via meerdere tussenstappen. Pas daarna je interne links aan zodat ze direct naar de eindbestemming wijzen.
5. Voeg dubbele content samen
Kies per onderwerp één hoofdversie. Stuur varianten met een redirect door of wijs met een canonical tag de hoofdversie aan. Zo hoeft Google minder bijna gelijke URL’s te bezoeken.
6. Maak je server sneller
Hoe sneller je server antwoordt, hoe meer Google kan ophalen zonder je site te belasten. Kijk vooral naar de reactietijd van de server: goede hosting en caching helpen hier het meest. Google raadt ook aan om HTTP-caching te ondersteunen, zodat je server bij een ongewijzigde pagina met statuscode 304 kan antwoorden. Voor de snelheid die bezoekers ervaren lees je meer over de Core Web Vitals.
Hoe controleer je hoe Google je site crawlt?
Dat doe je in Google Search Console. Ga naar Instellingen > Crawlstatistieken en klik op Rapport openen. Het rapport Crawlstatistieken laat de crawlactiviteit van Google op je site zien over de afgelopen 90 dagen.
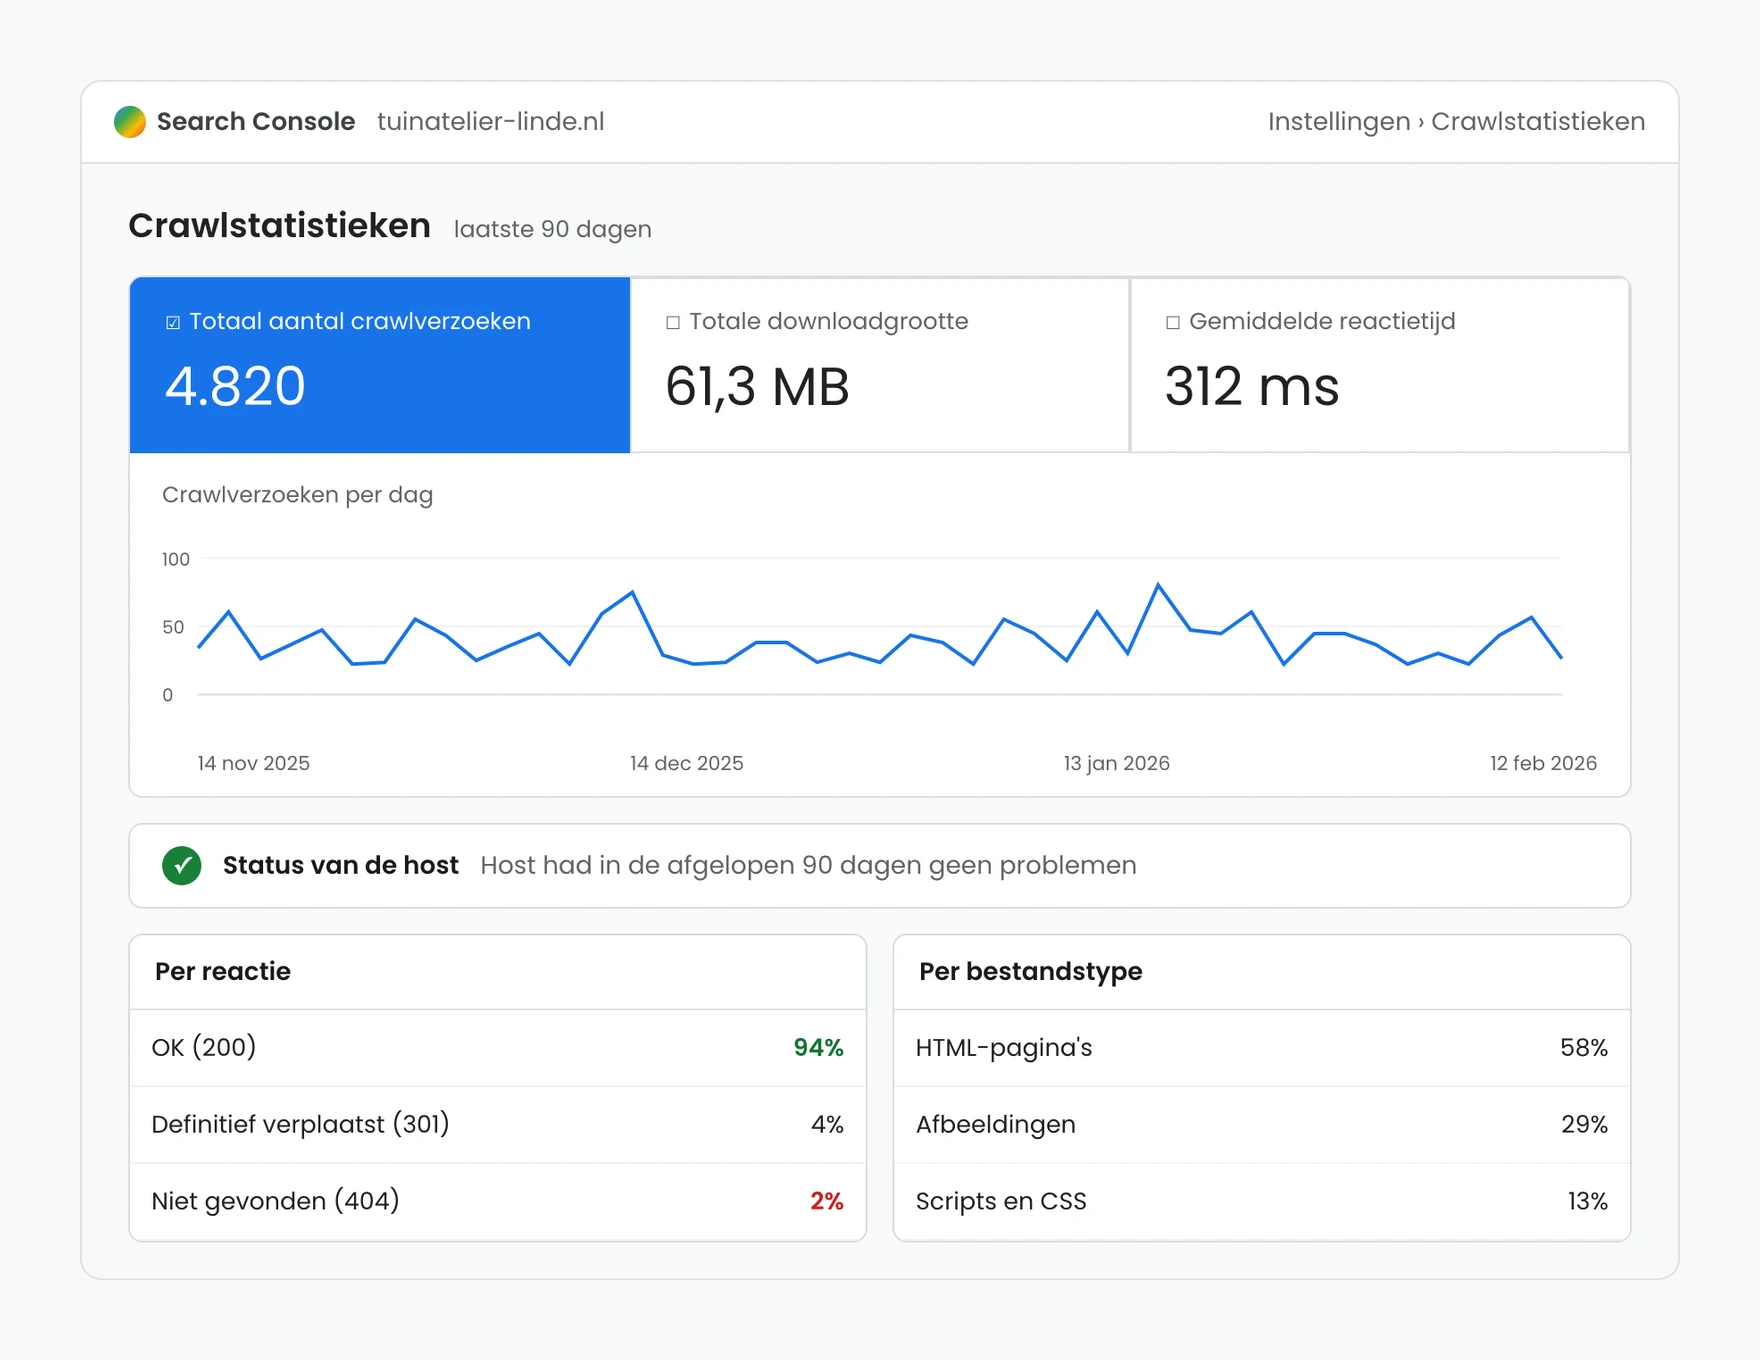
Dit zie je in het rapport:
- Totaal aantal crawlverzoeken, de totale downloadgrootte en de gemiddelde reactietijd van je server
- Hoststatus: of Google problemen had met je robots.txt, DNS of de verbinding met je server
- Uitsplitsing per reactie: hoeveel verzoeken een 200, een redirect, een 404 of een serverfout opleverden
- Uitsplitsing per bestandstype, doel en Googlebot-type: bijvoorbeeld of Google nieuwe pagina’s ontdekte of bekende pagina’s vernieuwde en of de smartphone- of desktopcrawler kwam
Zie je het aantal verzoeken flink dalen terwijl de reactietijd stijgt of de hoststatus rood wordt? Dan heeft Google moeite om je site te bereiken en is dat het eerste wat je oplost. Google legt alle onderdelen uit in de helppagina over het rapport Crawlstatistieken.
Wil je weten hoe het met één pagina staat, gebruik dan de URL-inspectietool. Die laat zien wanneer Googlebot de pagina voor het laatst heeft gecrawld, met welke crawler en of crawlen en indexeren is toegestaan. Wil je deze rapporten zelf leren lezen en gebruiken, dan is de Google Search Console training een goede volgende stap.
Crawlen in een notendop
Crawlen is de eerste stap om in Google te komen: zonder crawlen geen indexering en zonder indexering geen posities. Zorg dat Googlebot je pagina’s via links en je sitemap kan vinden, blokkeer alleen wat echt niet in Google hoeft en houd je server snel. Crawlbudget is vooral iets voor grote sites. Heb je een kleinere site, kijk dan eerst naar bereikbaarheid en kwaliteit van je pagina’s. Wil je die basis stap voor stap leren, kijk dan bij de SEO basistraining.
Veelgestelde vragen
Crawlen is het automatisch opvragen en lezen van webpagina’s door een zoekmachine. De crawler volgt links om nieuwe pagina’s te vinden en geeft de inhoud door, zodat de zoekmachine kan beslissen of de pagina in de index komt.
In SEO betekenen ze hetzelfde: een programma dat automatisch webpagina’s bezoekt. Bot is de algemene term. Crawler en spider verwijzen naar het volgen van links over het web. Googlebot is de crawler van Google.
Nee. Crawlen is het ophalen van een pagina. Indexeren is het analyseren en opslaan van die pagina in de database van Google. Een pagina kan gecrawld zijn zonder dat hij geïndexeerd wordt.
Technisch gezien wel, maar Google geeft aan dat crawlbudget vooral speelt bij sites met tienduizenden of meer pagina’s die vaak veranderen. Voor een kleinere site is het zelden de reden dat een pagina niet in Google staat.
Plak de URL in de URL-inspectietool van Search Console en klik op Indexering aanvragen. Voor veel pagina’s tegelijk dien je een bijgewerkte sitemap in. Een verzoek vaker herhalen maakt het niet sneller.
Ja, met een Disallow-regel in robots.txt. Doe dat alleen voor delen van je site die niet in Google hoeven. Blokkeer je per ongeluk belangrijke pagina’s of je CSS en JavaScript, dan kan Google je pagina’s niet goed lezen.
Geschreven door
Celine · Goldcompass
Online marketeer en trainer. Werkt dagelijks aan SEO, Google Ads en content voor ondernemers, en vertaalt dat naar praktische trainingen zonder jargon.
Zelf aan de slag met seo?
In de training SEO basistraining leer je het stap voor stap, direct toepasbaar op je eigen bedrijf.